Quando se fala de índices no SQL Server, a intuição diz que mais é melhor. Na prática, um índice mal avaliado pode ser mais prejudicial do que a sua ausência. O problema não está em criá-los — está em não os avaliar depois.
O SQL Server regista internamente informações detalhadas sobre a utilização de cada índice: quantas vezes foi usado em leituras, quantas operações de escrita gerou, quando foi acedido pela última vez. Esta informação existe e está disponível — simplesmente não está a ser consultada na maioria das organizações.
A métrica fundamental é o rácio entre escritas e leituras. Um índice bom tem uma taxa de leitura elevada; um índice mau tem muitas escritas para poucas leituras. Cada vez que um registo é inserido, atualizado ou eliminado, todos os índices da tabela têm de ser atualizados. É o custo de ter índices — e é um custo real, em CPU e I/O. O problema é que este rácio, sozinho, não chega para tomar decisões. É preciso contexto.
Quando os números enganam
Dois exemplos que parecem opostos — mas têm o mesmo problema: a leitura superficial dos números.
Antes de eliminar qualquer índice com base na taxa de utilização, vale a pena perceber duas coisas: quando é que é usado, e o que acontece se não existir. Às vezes a solução não é eliminar — é afinar.
A chave do índice e o histograma que decide tudo
Um índice é composto por dois elementos: os campos que formam a chave e os campos no INCLUDE. O primeiro campo da chave é o mais importante — é com base nele que o SQL Server constrói o histograma que usa para decidir se vale a pena usar o índice.
Um primeiro campo com muitos valores repetidos produz um histograma pobre. O SQL Server pode simplesmente ignorar o índice e optar por um Table Scan — mesmo que o índice exista e pareça adequado à query.
Isto cria um problema subtil: os dados mudam. Um campo com 1% de repetição em 2020 pode ter 80% em 2026, fruto da evolução do negócio. O índice que funcionava deixa de funcionar — não porque foi mal criado, mas porque a realidade mudou à volta dele.
A solução óbvia é reordenar os campos da chave — mas a base de dados ainda contém dados antigos para os quais o índice original fazia sentido. Nestes casos, índices filtrados podem ser uma saída, desde que as queries estejam construídas de forma compatível.
Duplicados e redundantes: o peso invisível
Com o tempo, bases de dados acumulam dois tipos de índices problemáticos que aumentam o custo de escrita sem acrescentar valor.
A solução ideal é fazer um merge — consolidar num único índice que cubra os casos relevantes. Nem sempre é possível: há situações em que a forma como as queries estão escritas torna a consolidação impraticável, e o melhor é manter os redundantes com consciência do custo que têm.
O Bom, o Mau e o Feio
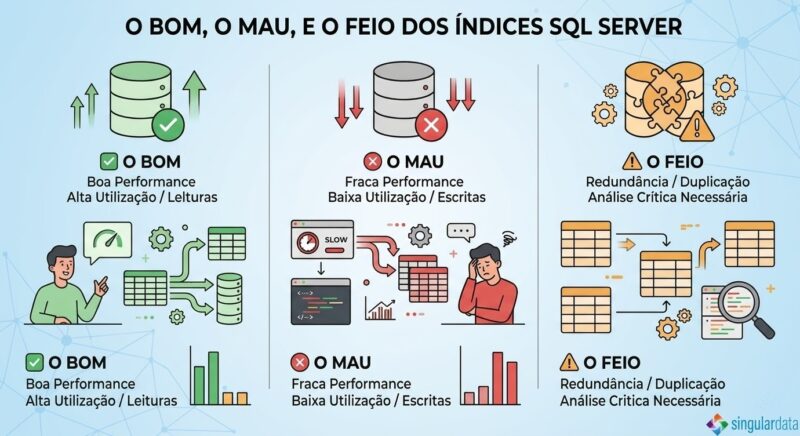
Com base nesta análise, é possível classificar os índices de qualquer base de dados em três categorias:
✗ O Mau — fraca utilização, penaliza a escrita
≈ O Feio — redundante, mas por vezes inevitável
A gestão de índices não é uma tarefa pontual. É um processo contínuo, porque os dados mudam, o software evolui, e o que era uma boa decisão há dois anos pode ser um problema hoje. A diferença entre uma base de dados bem afinada e uma que vai acumulando problemas de performance está frequentemente aqui — não em grandes projetos de reestruturação, mas na atenção regular a algo que parece invisível até deixar de funcionar.
Quer saber como estão os índices da sua base de dados?
Na Singular Data fazemos este tipo de análise com os nossos clientes: identificamos o que está a prejudicar a performance, percebemos o contexto antes de tomar medidas, e implementamos soluções que durem.