Os conceitos de Alta Disponibilidade (HA) e Recuperação de Desastres (DR) geram frequentemente confusão no ecossistema corporativo. Muitas empresas desenvolvem sistemas robustos de HA e consideram-nos, erradamente, como uma solução de DR autónoma. No entanto, ambos são componentes distintos e vitais para um plano de continuidade de negócio estruturado.
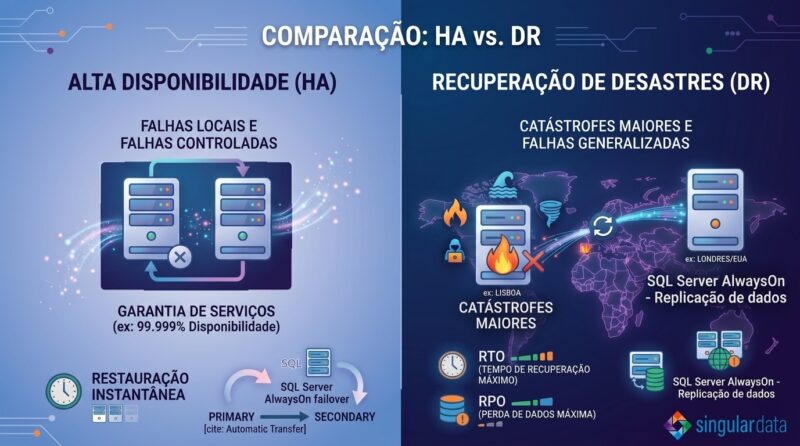
A principal diferença reside no âmbito da proteção. Enquanto a Alta Disponibilidade visa mitigar o impacto de falhas localizadas e manutenções planeadas, a Recuperação de Desastres prepara a infraestrutura para responder a cenários de catástrofe que comprometem múltiplos sistemas em simultâneo.
Alta Disponibilidade (HA): Continuidade em falhas localizadas
A Alta Disponibilidade é uma abordagem arquitetural desenhada para garantir níveis extremamente elevados de serviço técnico, tipicamente medidos na métrica dos “cinco noves” (99,999% de *uptime*). Esta configuração assegura que o sistema permanece operacional face a falhas de hardware específicas, avarias de discos ou atualizações de rotina.
Veja-se o caso prático do SQL Server configurado com AlwaysOn Availability Groups em modo síncrono: se o servidor que aloja a réplica primária falhar, o serviço transita de forma quase instantânea e automática para um nó secundário local, mantendo as aplicações ligadas com interrupção nula.
Neste cenário de HA, o problema fica estrito ao motor de base de dados. Os restantes componentes da infraestrutura — como redes, firewalls, armazenamento centralizado e servidores web locais — continuam intactos e a operar normalmente na mesma infraestrutura de dados.
Recuperação de Desastres (DR): Resposta a eventos macro
Por oposição, o Disaster Recovery entra em ação quando ocorre a perda total do centro de dados principal. Falamos de situações limite provocadas por ataques informáticos em grande escala (como *ransomware*), inundações, falhas severas de energia na região, sabotagem ou erros humanos catastróficos.
A estratégia de DR baseia-se na replicação integral do ambiente crítico para uma localização geográfica alternativa e remota. Se a infraestrutura de produção principal estiver localizada em Lisboa, o site de DR deverá estar idealmente posicionado noutra região ou país, como Londres ou Madrid, operando com replicação contínua ou agendada para salvaguardar a soberania dos dados.
O papel do RTO e RPO na arquitetura de resiliência
O desenho de um plano de DR robusto assenta obrigatoriamente na definição de duas métricas essenciais de negócio: o RTO (Recovery Time Objective), que estabelece a janela máxima tolerável de tempo de inatividade, e o RPO (Recovery Point Objective), que fixa o volume aceitável de perda de transações de dados.
Plataformas de topo como o SQL Server permitem configurar arquiteturas mistas (nós locais em modo síncrono para HA e nós remotos em modo assíncrono para DR). Isto viabiliza a obtenção de objetivos de recuperação muito rigorosos e “próximos de zero”. No entanto, cumpre recordar que o custo da infraestrutura cresce proporcionalmente à exigência destas métricas.
💡 Quer aprofundar estes indicadores?
Explicamos em detalhe como ajustar o RTO e o RPO ao plano de continuidade de negócio da sua organização.
Disaster Recovery Site
AlwaysOn Availability Groups
Business Continuity Plan
RTO & RPO Tuning
Em suma, confundir Alta Disponibilidade com Recuperação de Desastres é um risco grave que pode paralisar uma empresa. A HA protege o uptime diário contra falhas localizadas, enquanto a DR atua como a apólice de seguro contra catástrofes de grande escala. Para salvaguardar a estabilidade global, as duas abordagens tecnológicas devem ser entendidas como estratégias perfeitamente necessárias e complementares.
Precisa de uma estratégia de HA e DR robusta?
Na Singular Data ajudamos as empresas a desenhar, auditar e implementar arquiteturas completas de Alta Disponibilidade e Recuperação de Desastres em SQL Server. Alinhamos o investimento técnico com as reais necessidades do seu negócio.